مدلهای زبانی چگونه در سال ۲۰۲۶ تغییر کردهاند؟
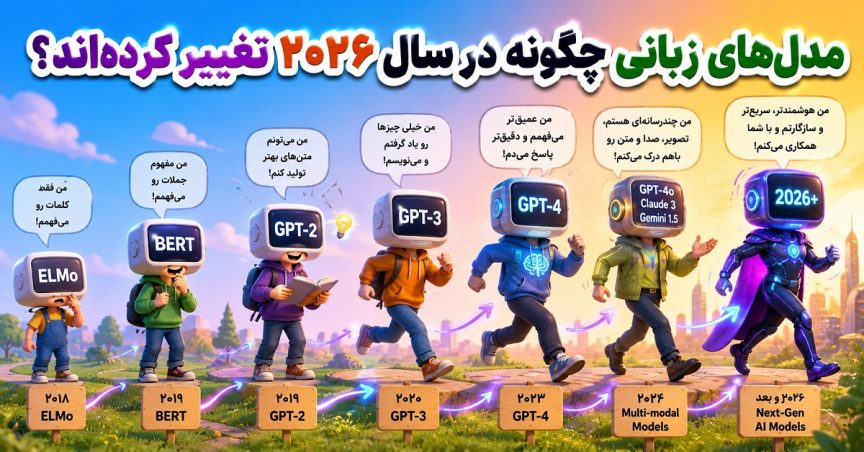
مدلهای زبانی بزرگ یا LLMها در سال ۲۰۲۶ دیگر فقط ابزارهایی برای پاسخ دادن به سؤالها و تولید متن نیستند. این فناوریها بهسمت استدلال چندمرحلهای، تحلیل حجم زیادی از اطلاعات، درک همزمان متن و تصویر، برنامهنویسی پیشرفته و همکاری با ابزارهای نرمافزاری حرکت کردهاند.
در نسلهای اولیه، بیشتر کاربران از مدلهای زبانی برای نوشتن متن، خلاصهسازی، ترجمه و پاسخ به پرسشهای عمومی استفاده میکردند. اما اکنون بسیاری از مدلهای پیشرفته میتوانند یک مسئله پیچیده را به چند مرحله تقسیم کنند، فایلهای مختلف را بررسی کنند، کد بنویسند، از ابزارهای بیرونی کمک بگیرند و برای رسیدن به نتیجه، چند مرحله از کار را پشت سر هم انجام دهند.
البته همه مدلها چنین قابلیتهایی ندارند و میزان توانایی آنها به معماری، دادههای آموزشی، ابزارهای متصل، محدودیتهای اجرایی و هزینه استفاده بستگی دارد.
در این مقاله بررسی میکنیم که مدلهای زبانی در سال ۲۰۲۶ چه تغییراتی کردهاند، چه تفاوتی با نسلهای قبلی دارند، این تغییرات چه کاربردهایی برای کاربران و کسبوکارها ایجاد کردهاند و برای انتخاب و استفاده از مدلهای جدید باید به چه نکاتی توجه کرد.
مدل زبانی بزرگ چیست و چگونه کار میکند؟
مدل زبانی بزرگ یا Large Language Model که به اختصار LLM نامیده میشود، نوعی مدل هوش مصنوعی است که برای پردازش و تولید زبان آموزش دیده است. این مدلها با یادگیری الگوهای موجود در دادهها، میتوانند متن تولید کنند، سؤالها را پاسخ دهند، اطلاعات را دستهبندی کنند، کد بنویسند و بسیاری از وظایف مرتبط با زبان را انجام دهند.
در سادهترین حالت، مدل بر اساس ورودی دریافتشده، خروجی را مرحلهبهمرحله تولید میکند. اما مدلهای مدرن با روشهای آموزشی و قابلیتهای تکمیلی، عملکردی فراتر از تکمیل ساده متن دارند.
برای مثال، یک مدل زبانی میتواند درخواست زیر را پردازش کند:
«این گزارش فروش را بررسی کن، محصولات پرفروش را مشخص کن، تغییرات ماهانه را توضیح بده و سه پیشنهاد برای بهبود فروش ارائه کن.»
برای پاسخ به چنین درخواستی، مدل باید اطلاعات ورودی را بفهمد، روابط میان دادهها را بررسی کند، نتیجهگیری کند و خروجی را در قالبی قابلاستفاده ارائه دهد. اگر به ابزار تحلیل داده یا اجرای کد دسترسی داشته باشد، ممکن است بتواند محاسبات را نیز انجام دهد.
نکته مهم این است که مدل زبانی الزاماً یک پایگاه داده کامل یا منبع حقیقت نیست. پاسخ آن ممکن است اشتباه باشد و دانش داخلی مدل نیز ممکن است اطلاعات روز را پوشش ندهد. به همین دلیل، اتصال به منابع معتبر و ابزارهای بیرونی در بسیاری از کاربردهای حرفهای اهمیت دارد.
۱. حرکت از تولید متن به استدلال چندمرحلهای
یکی از تغییرات مهم مدلهای زبانی، توسعه قابلیتهای استدلال است. مدلهای جدیدتر در برخی وظایف پیچیده، مانند ریاضیات، برنامهنویسی، تحلیل داده و حل مسائل چندمرحلهای، از روشهایی استفاده میکنند که به آنها اجازه میدهد پیش از ارائه پاسخ نهایی، مراحل بیشتری از مسئله را پردازش کنند.
در گذشته، یک مدل ممکن بود در پاسخ به مسئلهای پیچیده، سریع به نتیجه برسد اما بخشی از مراحل را نادیده بگیرد. مدلهای استدلالی تلاش میکنند مسئله را ساختارمندتر بررسی کنند، راهحلهای احتمالی را ارزیابی کنند و در صورت نیاز محاسبات یا بررسیهای بیشتری انجام دهند.
برای نمونه، در یک مسئله برنامهنویسی ممکن است لازم باشد مدل ابتدا کد موجود را تحلیل کند، علت خطا را پیدا کند، راهحل پیشنهاد دهد و سپس تغییرات را آزمایش کند.
این روند میتواند کیفیت پاسخ را در بعضی وظایف افزایش دهد، اما به معنای بیخطا شدن مدل نیست. حتی مدلهای قدرتمند نیز ممکن است در محاسبات، استدلال یا تفسیر اطلاعات اشتباه کنند.
آیا استدلال بیشتر همیشه بهتر است؟
خیر. برای درخواستهای ساده مانند اصلاح یک جمله یا ترجمه یک عبارت کوتاه، استفاده از مدلی با استدلال سنگین ممکن است ضرورتی نداشته باشد.
در مقابل، برای تحلیل یک قرارداد، بررسی چند فایل مرتبط، طراحی یک سیستم نرمافزاری یا حل مسئلهای پیچیده، اختصاص منابع بیشتر به استدلال میتواند مفید باشد؛ البته در موضوعات حساس، بررسی انسانی همچنان اهمیت دارد.
به همین دلیل، در سال ۲۰۲۶ انتخاب مدل مناسب فقط به قدرت خام آن وابسته نیست. باید میان کیفیت پاسخ، سرعت، هزینه و پیچیدگی کار تعادل برقرار کرد.
۲. گسترش پنجره زمینه و پردازش اطلاعات طولانی
یکی دیگر از تغییرات مهم، افزایش ظرفیت برخی مدلها برای دریافت و پردازش اطلاعات طولانی است. این قابلیت با اصطلاح Context Window یا پنجره زمینه شناخته میشود.
پنجره زمینه مشخص میکند که مدل در یک درخواست یا تعامل، چه میزان اطلاعات را میتواند در نظر بگیرد. این اطلاعات ممکن است شامل متن کاربر، تاریخچه گفتوگو، اسناد، بخشهایی از کد و خروجی ابزارهای متصل باشد.
در برخی مدلهای جدید، پنجره زمینه به صدها هزار یا بیش از یک میلیون توکن رسیده است. برای نمونه، مستندات رسمی Google AI برای برخی مدلهای Gemini از پنجره زمینه یکمیلیونتوکنی یا بیشتر صحبت میکنند. https://ai.google.dev/gemini-api/docs/long-context
این قابلیت چه کاربردی دارد؟
فرض کنید میخواهید یک گزارش چندصدصفحهای را بررسی کنید. در مدلهایی با ظرفیت زمینه محدود، ممکن است مجبور شوید فایل را به بخشهای کوچکتر تقسیم کنید و هر قسمت را جداگانه تحلیل کنید.
مدلی با پنجره زمینه بزرگتر ممکن است بتواند بخش بیشتری از اسناد را در یک تعامل دریافت کند و به پرسشهایی درباره ارتباط میان قسمتهای مختلف پاسخ دهد.
کاربردهای مهم این قابلیت عبارتاند از:
- بررسی گزارشهای طولانی و اسناد سازمانی
- تحلیل مجموعهای از فایلهای متنی
- مرور کد یک پروژه بزرگ
- مقایسه چند قرارداد یا سند
- خلاصهسازی مصاحبهها و متنهای طولانی
- پاسخگویی بر اساس مجموعهای از منابع ارائهشده توسط کاربر
آیا پنجره زمینه بزرگ تضمینکننده درک کامل است؟
خیر. توانایی دریافت حجم زیادی از اطلاعات با توانایی استفاده دقیق از تمام آن اطلاعات یکسان نیست.
ممکن است مدل در یک سند طولانی، جزئیات مهمی را نادیده بگیرد یا ارتباط میان دو بخش را اشتباه تفسیر کند. بنابراین، برای کارهای مهم باید از پرسشهای دقیق، بررسی بخشهای حساس و ارزیابی خروجی استفاده کرد.
همچنین پنجره زمینه بزرگ میتواند مصرف توکن و هزینه پردازش را افزایش دهد. به همین دلیل، در بسیاری از پروژهها انتخاب گزیدهای از اطلاعات مرتبط همچنان بهتر از وارد کردن تمام اسناد است.
۳. مدلهای چندوجهی؛ فراتر از متن
مدلهای زبانی اولیه عمدتاً با متن سروکار داشتند، اما بسیاری از مدلهای پیشرفته امروز بخشی از سامانههای چندوجهی یا Multimodal AI هستند.
مدل چندوجهی میتواند با بیش از یک نوع داده کار کند؛ برای مثال متن، تصویر، صدا و ویدئو. بعضی مدلها علاوه بر دریافت این دادهها، توانایی تولید صدا یا تصویر را نیز در قالب ابزارها و قابلیتهای جداگانه دارند.
این تحول باعث شده است که کاربر بتواند بهجای توضیح کامل یک مسئله با متن، تصویر یا فایل صوتی ارائه دهد و درباره آن سؤال بپرسد.
نمونههای کاربردی
تحلیل تصویر: کاربر میتواند تصویر یک نمودار را ارسال کند و از مدل بخواهد روندها و تغییرات مهم آن را توضیح دهد.
درک صوت: مدل میتواند در برخی سامانهها به پردازش گفتار، تبدیل صوت به متن یا پاسخگویی صوتی کمک کند.
تحلیل ویدئو: در صورت پشتیبانی مدل، میتوان درباره بخشهایی از یک ویدئو سؤال پرسید یا محتوای آن را خلاصه کرد.
کار با اسناد: مدل ممکن است متن، جدول و عناصر تصویری موجود در یک سند را با هم بررسی کند؛ میزان دقت به فرمت فایل و قابلیتهای سرویس بستگی دارد.
مستندات رسمی Gemini نمونههایی از پردازش متن، تصویر، صدا و ویدئو و کاربرد پنجره زمینه بزرگ در تحلیل دادههای چندوجهی را شرح میدهند. https://ai.google.dev/gemini-api/docs/long-context
بااینحال، نباید فرض کرد که تمام مدلها همه این قابلیتها را بهصورت یکسان دارند. برخی مدلها در تحلیل متن قویترند، بعضی برای صدا بهینه شدهاند و برخی دیگر برای تصویر یا وظایف تخصصی طراحی شدهاند.
۴. مدلهای زبانی به عاملهای هوش مصنوعی نزدیکتر شدهاند
یکی از روندهای مهم سال ۲۰۲۶، ترکیب مدلهای زبانی با ابزارها و سازوکارهایی است که امکان انجام کارهای چندمرحلهای را فراهم میکنند.
مدل زبانی بهتنهایی معمولاً متن یا خروجی تولید میکند. اما وقتی به ابزارهایی مانند جستجوی وب، اجرای کد، دسترسی کنترلشده به فایلها یا رابطهای نرمافزاری متصل شود، میتواند در یک فرایند بزرگتر نقش تصمیمگیرنده یا هماهنگکننده را ایفا کند.
چنین سامانهای ممکن است بهعنوان AI Agent یا عامل هوش مصنوعی شناخته شود.
برای مثال، یک عامل هوش مصنوعی برای تحلیل بازار ممکن است بتواند:
۱. موضوع تحقیق را به پرسشهای کوچکتر تقسیم کند.
۲. منابع مرتبط را پیدا کند.
۳. اطلاعات را در یک ساختار منظم جمعآوری کند.
۴. دادهها را با یکدیگر مقایسه کند.
۵. گزارشی اولیه تولید کند.
۶. موارد نامطمئن را برای بررسی انسانی مشخص کند.
در این فرایند، مدل زبانی نقش مهمی دارد، اما کل سامانه فقط از مدل تشکیل نشده است. ابزارها، مجوزهای دسترسی، حافظه، مدیریت خطا و قواعد اجرایی نیز در نتیجه نهایی نقش دارند.
تفاوت مدل زبانی و عامل هوش مصنوعی چیست؟
مدل زبانی موتور پردازش و تولید پاسخ است؛ عامل هوش مصنوعی یک سامانه کاربردی است که ممکن است از مدل زبانی برای برنامهریزی و انتخاب اقدامات استفاده کند.
بنابراین، هر مدل زبانی یک عامل هوش مصنوعی نیست. همچنین، هر عاملی که از مدل زبانی استفاده میکند الزاماً مستقل یا قابلاعتماد نیست. اجرای اقدامات مهم باید با محدودیتهای روشن و در صورت نیاز با تأیید کاربر انجام شود.
۵. بهبود توانایی برنامهنویسی و کار با کد
برنامهنویسی یکی از حوزههایی است که تغییرات مدلهای زبانی در آن بهوضوح دیده میشود. مدلهای جدیدتر میتوانند در نوشتن کد، توضیح ساختار پروژه، یافتن خطاها، پیشنهاد اصلاحات و تولید آزمونهای نرمافزاری کمک کنند.
در بعضی محیطهای توسعه، مدل به فایلهای پروژه و ابزارهای اجرای کد دسترسی دارد. در این شرایط، بهجای تولید یک قطعه کد مستقل، میتواند در یک فرایند چندمرحلهای مشارکت کند: ابتدا فایلهای مرتبط را بررسی کند، سپس تغییرات پیشنهادی را ایجاد کند و در صورت دسترسی به محیط اجرا، نتیجه را آزمایش کند.
کاربردهای عملی مدلهای جدید در برنامهنویسی
- ساخت نمونه اولیه یک وبسایت یا اپلیکیشن
- توضیح کدهای قدیمی و پیچیده
- شناسایی برخی خطاهای برنامهنویسی
- نوشتن آزمون برای بررسی عملکرد کد
- مستندسازی توابع و بخشهای مختلف پروژه
- کمک به تبدیل نیازهای متنی به وظایف فنی
- بررسی خطاهای احتمالی در معماری نرمافزار
بااینحال، تولید کد به معنای تولید نرمافزار امن و آماده انتشار نیست. کد تولیدشده ممکن است باگ داشته باشد، عملکرد نامناسبی ارائه کند یا آسیبپذیری امنیتی ایجاد کند. اجرای آزمونها، بازبینی کد و بررسی امنیت باید بخشی از فرایند توسعه باقی بمانند.
۶. مدلهای کوچکتر و تخصصیتر اهمیت بیشتری پیدا کردهاند
یکی از برداشتهای نادرست درباره پیشرفت مدلهای زبانی این است که همیشه بزرگترین مدل، بهترین انتخاب برای تمام کارهاست. در عمل، بسیاری از کاربردها به مدلی نیاز دارند که سریع، کمهزینه و برای وظیفه مشخصی بهینه شده باشد.
به همین دلیل، در کنار مدلهای قدرتمند عمومی، مدلهای کوچکتر و تخصصی نیز توسعه یافتهاند. برخی برای دستهبندی متن، استخراج اطلاعات، تبدیل گفتار به متن، تولید صدا، خلاصهسازی یا پاسخگویی سریع طراحی میشوند.
چرا مدل کوچکتر میتواند انتخاب مناسبی باشد؟
فرض کنید یک فروشگاه اینترنتی روزانه هزاران پیام مشتری دریافت میکند و میخواهد پیامها را در دستههایی مانند پیگیری سفارش، مرجوعی کالا، درخواست اطلاعات و پشتیبانی فنی قرار دهد.
برای این وظیفه محدود، استفاده از یک مدل سریع و کمهزینه ممکن است از بهکارگیری یک مدل بسیار بزرگ برای هر پیام منطقیتر باشد.
مزایای احتمالی مدلهای کوچکتر عبارتاند از:
- هزینه کمتر برای پردازش تعداد زیادی درخواست
- سرعت پاسخگویی بیشتر در برخی کاربردها
- امکان اجرای محلی روی سختافزار مناسب
- کنترل بهتر بر یک وظیفه مشخص
- کاهش وابستگی به سرویسهای بیرونی در بعضی پیادهسازیها
البته مدل کوچکتر ممکن است در تحلیل پیچیده، استدلال چندمرحلهای یا وظایف متنوع عملکرد ضعیفتری داشته باشد. انتخاب نهایی باید بر اساس آزمون واقعی، کیفیت موردنیاز، هزینه و محدودیتهای فنی انجام شود.
۷. اتصال مدلها به ابزارها و منابع بیرونی
مدلهای زبانی بهتنهایی معمولاً به تمام اطلاعات لحظهای یا دادههای خصوصی موردنیاز کاربر دسترسی ندارند. برای گسترش کاربرد آنها، از روشهایی مانند جستجوی وب، بازیابی اطلاعات از اسناد و فراخوانی ابزارها استفاده میشود.
یکی از روشهای مهم، تولید تقویتشده با بازیابی اطلاعات یا RAG است. در این روش، سامانه ابتدا اطلاعات مرتبط را از یک مجموعه اسناد یا پایگاه داده بازیابی میکند و سپس آن اطلاعات را در اختیار مدل قرار میدهد تا پاسخ مناسبی تولید کند.
برای مثال، یک شرکت میتواند اسناد راهنمای داخلی، سیاستهای پشتیبانی و اطلاعات محصولات خود را در یک سامانه قابل جستجو قرار دهد. هنگامی که کارمند سؤالی میپرسد، سامانه بخشهای مرتبط را بازیابی میکند و مدل بر اساس آنها پاسخ میدهد.
این روش میتواند به استفاده از اطلاعات اختصاصی و بهروزتر کمک کند؛ اما کیفیت پاسخ به کیفیت اسناد، دقت بازیابی، طراحی سامانه و نحوه استناد به منابع وابسته است.
تفاوت RAG با آموزش مجدد مدل
در RAG، معمولاً دانش موردنیاز هنگام پاسخگویی از منابع بیرونی بازیابی میشود. در آموزش مجدد یا تنظیم دقیق مدل، پارامترهای مدل با استفاده از دادههای آموزشی تغییر میکنند.
این دو روش کاربردهای متفاوتی دارند. اگر اطلاعات شرکت مرتب تغییر میکند، بازیابی از اسناد میتواند راهی عملی برای دسترسی به نسخه جدید اطلاعات باشد. اگر هدف تغییر رفتار مدل برای یک وظیفه مشخص است، تنظیم دقیق ممکن است گزینه مناسبتری باشد.
در بسیاری از پروژهها، ترکیب روشهای مختلف بهترین نتیجه را میدهد.
مهمترین ترندهای هوش مصنوعی در سال ۲۰۲۶ که باید بشناسیم
۸. تغییر مدلهای زبانی در سال ۲۰۲۶؛ مقایسه کلی
جدول زیر تفاوتهای کلی میان نسلهای اولیه مدلهای زبانی و روندهای رایج در مدلهای پیشرفتهتر را نشان میدهد. این مقایسه توصیفی است؛ زیرا مدلهای مختلف با سرعت متفاوتی پیشرفت کردهاند و همه قابلیتها در تمام محصولات وجود ندارند.
| حوزه | رویکرد رایج در نسلهای اولیه | روند در مدلهای پیشرفتهتر |
|---|---|---|
| تولید متن | پاسخگویی و تکمیل متن | تولید متن همراه با تحلیل وظایف پیچیدهتر |
| استدلال | عملکرد محدودتر در برخی مسائل چندمرحلهای | روشهای پیشرفتهتر برای حل مسائل پیچیده |
| حجم اطلاعات | محدودیت بیشتر در زمینه ورودی | پنجره زمینه بزرگتر در برخی مدلها |
| نوع ورودی | تمرکز بیشتر بر متن | پشتیبانی چندوجهی در مدلهای منتخب |
| برنامهنویسی | تولید قطعه کد و توضیح | کمک به کار با پروژه، آزمون و اصلاح کد در محیطهای مجهز |
| ابزارهای بیرونی | وابستگی بیشتر به ورودی مستقیم کاربر | اتصال به جستجو، فایلها و ابزارهای اجرایی |
| اجرای وظایف | تولید پاسخ در یک مرحله | پشتیبانی از فرایندهای چندمرحلهای در سامانههای عاملمحور |
| هزینه و سرعت | تنوع محدودتر در برخی محصولات | انتخاب گستردهتر میان مدلهای سریع، کوچک و قدرتمند |
این جدول به معنای آن نیست که تمام مدلهای جدید در همه زمینهها از مدلهای قدیمی بهترند. در بعضی وظایف مشخص، یک مدل کوچک یا قدیمیتر ممکن است به دلیل سرعت، هزینه یا سازگاری با نرمافزار موردنظر انتخاب مناسبتری باشد.
۹. نگاهی به مدلهای مهم در سال ۲۰۲۶
برای درک بهتر تغییرات، میتوان خانوادههای مختلف مدلها را بر اساس کاربرد و رویکرد آنها بررسی کرد.
مدلهای GPT
خانواده GPT در محصولات مکالمهای و ابزارهای توسعه نرمافزار کاربرد دارد. بسته به مدل و محیط استفاده، قابلیتهایی مانند پردازش متن و تصویر، استدلال، جستجوی وب، کار با فایلها و فراخوانی ابزارها در دسترس قرار میگیرند.
هنگام انتخاب یک مدل از این خانواده، باید به قابلیتهای همان نسخه، محدودیتهای استفاده و امکانات محیطی که آن را ارائه میکند توجه کرد. نام یک خانواده بهتنهایی برای تعیین توانایی دقیق آن کافی نیست.
اطلاعات بهروز مدلها و قابلیتهای توسعهدهندگان را میتوان در مستندات رسمی OpenAI بررسی کرد.
خانواده Gemini
مدلهای Gemini از جمله نمونههای شناختهشده در زمینه پردازش چندوجهی و کار با زمینه طولانی هستند. برخی نسخهها برای پاسخگویی سریع، برخی برای استدلال پیچیده و برخی برای وظایف تخصصی یا صوتی طراحی شدهاند.
ظرفیت زمینه، شیوه پردازش فایلها و امکانات هر نسخه متفاوت است؛ بنابراین پیش از انتخاب، باید مشخصات همان مدل بررسی شود.
برای مشاهده فهرست نسخهها و قابلیتهای آنها، به مستندات رسمی Gemini API مراجعه کنید.
مدلهای متنباز و وزنباز
در کنار سرویسهای تجاری، مدلهایی با وزنهای قابلدسترسی نیز وجود دارند که به توسعهدهندگان امکان میدهند آنها را روی زیرساخت خود اجرا یا برای کاربردهای مشخص تنظیم کنند؛ البته مجوز استفاده، نیاز سختافزاری و میزان دسترسی به اجزای مدل در پروژههای مختلف متفاوت است.
این مدلها برای سازمانهایی که به کنترل بیشتر بر دادهها، سفارشیسازی یا کاهش وابستگی به سرویسهای خارجی نیاز دارند، میتوانند جذاب باشند.
در مقابل، اجرای محلی ممکن است به سختافزار قدرتمند، دانش فنی و هزینه نگهداری نیاز داشته باشد. همچنین، قابلدسترسی بودن وزنهای مدل به معنای متنباز بودن تمام اجزای آن یا آزاد بودن هر نوع استفاده نیست.
۱۰. تأثیر تغییرات مدلهای زبانی بر کسبوکارها
پیشرفت مدلهای زبانی تنها یک تغییر فنی نیست؛ این فناوری میتواند شیوه انجام برخی کارهای روزمره سازمانها را نیز تغییر دهد.
پشتیبانی از مشتری
مدل میتواند پیامها را دستهبندی کند، پاسخ اولیه پیشنهاد دهد و اطلاعات مرتبط با درخواست را از اسناد داخلی بازیابی کند. در موارد پیچیده، سامانه باید امکان ارجاع به نیروی انسانی را فراهم کند.
بازاریابی و تولید محتوا
مدلهای زبانی میتوانند برای ایدهپردازی، ساختاردهی محتوا، تدوین پیشنویس، بازنویسی و تحلیل بازخورد مخاطبان استفاده شوند. بااینحال، انتشار خودکار حجم زیادی از محتوای کمارزش لزوماً نتیجه خوبی ایجاد نمیکند. بررسی واقعیتها، ویرایش انسانی و افزودن تجربه یا تحلیل اصیل همچنان اهمیت دارد.
تحلیل اسناد و دادهها
کسبوکارها میتوانند از مدلها برای استخراج اطلاعات از اسناد، تهیه خلاصه مدیریتی و پاسخگویی به پرسشهای مربوط به دادهها استفاده کنند. برای محاسبات حساس، خروجی باید با ابزارهای معتبر و دادههای اصلی تطبیق داده شود.
توسعه نرمافزار
مدلها میتوانند در مستندسازی، تولید آزمون، تحلیل خطا و ساخت نمونههای اولیه به توسعهدهندگان کمک کنند. میزان صرفهجویی در زمان به نوع پروژه، کیفیت ابزار و تجربه برنامهنویس بستگی دارد.
اتوماسیون فرایندها
ترکیب مدل زبانی با APIها، پایگاههای داده و ابزارهای اجرایی میتواند برخی وظایف تکراری را خودکار کند. بااینحال، اقدامهای پرریسک مانند حذف دادهها، ارسال انبوه پیامها یا تغییرات مالی باید محدودیت دسترسی و سازوکار تأیید داشته باشند.
۱۱. محدودیتها و چالشهای مدلهای زبانی جدید
با وجود پیشرفتها، مدلهای زبانی هنوز محدودیتهای مهمی دارند. شناخت این محدودیتها برای استفاده حرفهای ضروری است.
تولید اطلاعات نادرست
مدل ممکن است پاسخی روان اما نادرست ارائه کند. این موضوع در اطلاعات تخصصی، آمار، ارجاعات علمی و جزئیات فنی اهمیت زیادی دارد.
محدودیت دانش و بهروزبودن
دانش داخلی مدل ممکن است همه تغییرات جدید را پوشش ندهد. اتصال به وب یا منابع بیرونی میتواند کمککننده باشد، اما کیفیت منابع و زمان دسترسی باید بررسی شود.
ضعف در اجرای وظایف پیچیده
یک مدل ممکن است در برنامهریزی درست عمل کند، اما در اجرای یکی از مراحل خطا کند. هرچه تعداد مراحل و وابستگیها بیشتر باشد، نیاز به بررسی خروجیهای میانی و مدیریت خطا نیز افزایش پیدا میکند.
حریم خصوصی و امنیت
ارسال اطلاعات محرمانه به سرویسهای هوش مصنوعی ممکن است با سیاستهای سازمان یا الزامات قانونی ناسازگار باشد. باید شرایط استفاده، نحوه نگهداری دادهها، مجوزها و تنظیمات امنیتی هر سرویس بررسی شوند.
هزینه و مصرف منابع
مدلهای قدرتمند، پنجره زمینه بزرگ و وظایف چندمرحلهای میتوانند هزینه بیشتری ایجاد کنند. انتخاب مدل متناسب با پیچیدگی کار و آزمایش روی نمونههای واقعی به مدیریت هزینه کمک میکند.
وابستگی بیش از حد به مدل
مدلهای زبانی ابزارهایی برای تقویت توانایی انسان هستند، نه جایگزین قطعی قضاوت تخصصی. در تصمیمهای مهم باید مسئولیت نهایی، ارزیابی شواهد و امکان بازبینی مشخص باشد.
۱۲. چگونه مدل زبانی مناسب را انتخاب کنیم؟
بهترین مدل برای همه کاربران و همه وظایف یکسان نیست. برای انتخاب منطقی، ابتدا باید مشخص کنید چه کاری را میخواهید انجام دهید و چه محدودیتهایی دارید.
برای نوشتن و ویرایش متن: کیفیت زبان، رعایت دستورالعملها و توانایی حفظ لحن اهمیت دارد.
برای تحلیل اسناد طولانی: ظرفیت زمینه، کیفیت بازیابی اطلاعات و توانایی ارجاع به بخشهای مشخص سند را بررسی کنید.
برای برنامهنویسی: توانایی درک ساختار پروژه، کیفیت کد، سازگاری با ابزارهای توسعه و عملکرد در آزمونهای واقعی مهم است.
برای تحقیق: قابلیت جستجوی منابع، کیفیت ارجاعات، بهروزبودن اطلاعات و امکان راستیآزمایی را در نظر بگیرید.
برای اتوماسیون: پشتیبانی از ابزارها، مدیریت خطا، سطح دسترسی و امکان تأیید انسانی اهمیت ویژهای دارند.
برای استفاده پرتکرار: هزینه هر درخواست، سرعت پاسخگویی و امکان استفاده از مدل کوچکتر را بررسی کنید.
در نهایت، بهتر است چند مدل را با مجموعهای از پرسشهای واقعی خود آزمایش کنید. بهجای اتکا به یک امتیاز عمومی یا تبلیغات سازنده، کیفیت خروجی، نرخ خطا، زمان اجرا و هزینه را در همان وظیفهای بسنجید که قرار است انجام دهید.
جمعبندی
مدلهای زبانی در سال ۲۰۲۶ از ابزارهایی که بیشتر برای تولید و پردازش متن استفاده میشدند، به بخش مهمی از سامانههای هوش مصنوعی چندوجهی، ابزارمحور و عاملمحور تبدیل شدهاند.
افزایش ظرفیت زمینه، پیشرفت در استدلال، توانایی پردازش انواع داده، بهبود کمک به برنامهنویسی و اتصال به منابع بیرونی از مهمترین روندهای این حوزه هستند. در کنار مدلهای بزرگ و قدرتمند، مدلهای کوچکتر و تخصصی نیز برای کارهای سریع و پرتکرار اهمیت دارند.
بااینحال، هیچیک از این تغییرات به معنای حذف خطا یا بینیازی از نظارت انسانی نیست. انتخاب درست مدل، بررسی منابع، حفاظت از دادهها و ارزیابی خروجی همچنان بخش جداییناپذیر استفاده حرفهای از هوش مصنوعی هستند.
درک این تغییرات به کاربران و کسبوکارها کمک میکند تا بهجای انتخاب مدل صرفاً بر اساس شهرت یا اندازه، ابزار مناسبی برای نیاز واقعی خود پیدا کنند و از هوش مصنوعی به شکلی دقیقتر، اقتصادیتر و مسئولانهتر بهره ببرند.
مطالب مرتبط